
__26J27d31Gs.png)
- 도입: 31조 6,000억 달러의 컴퓨팅 인프라 투자를 어떻게 토큰 생산 역량과 AI 생산성으로 전환할 것인가?
- 시장 인사이트 1. 수조 달러 규모의 컴퓨팅 인프라 투자, 하드웨어와 전력 설비에 집중되다
- 시장 인사이트 2. Agentic AI는 가치를 확대하는 동시에 컴퓨팅 및 토큰 비용도 증가시킨다
- 시장 인사이트 3. 제조업의 AI 확산이 본격화되면서 이기종 컴퓨팅 환경이 새로운 표준이 된다
- 시장 인사이트 4. 평가 기준의 전환: 'GPU 보유량'에서 '토큰 생산량'으로
- 시장 인사이트 5. 학습, 추론, Agentic AI에는 서로 다른 자원 스케줄링이 필요하다
- 시장 인사이트 6. GPU를 구매했는데도 생산성이 높아지지 않는 이유: 5가지 핵심 병목 요인
- INFINITIX AI-Stack × ixCSP: 소프트웨어로 하드웨어를 정의하고 완전한 Token Factory를 구현하다
- AI-Stack: GPU 자산을 스케줄링 가능한 컴퓨팅 자원 풀로 전환하다
- ixCSP: 컴퓨팅 자원을 측정 가능한 AI 서비스로 전환하다
- 권장 도입 단계
- 결론: 다음 경쟁의 핵심은 GPU 한 장당 토큰 생산 역량이다
도입: 31조 6,000억 달러의 컴퓨팅 인프라 투자를 어떻게 토큰 생산 역량과 AI 생산성으로 전환할 것인가?
기업들이 AI 서버, GPU 클러스터, 데이터센터에 투자하는 비용은 지속적으로 증가하고 있다. 그러나 하드웨어의 수량이 곧 실제 활용 가능한 AI 생산성을 의미하지는 않는다. AI의 확장성을 제한하는 진정한 요인은 GPU 유휴 자원, 리소스 단편화, 워크로드 대기, 이기종 컴퓨팅 자원의 통합 관리의 어려움, 불투명한 추론 비용인 경우가 많다.
2026년 하반기에 발표된 여러 글로벌 컨설팅 기관의 보고서는 공통된 결론을 제시한다. AI 인프라의 평가 기준이 'GPU를 얼마나 보유하고 있는가'에서 '시스템이 전력과 컴퓨팅 자원을 얼마나 효율적으로 토큰, 추론 결과 및 완료된 AI 작업으로 전환할 수 있는가'로 변화하고 있다는 것이다. Token Factory의 핵심 산출물은 측정 가능한 토큰 처리량(Token Throughput)으로 정의되고 있다.
INFINITIX(인피니틱스)는 PwC, McKinsey, Bain, BCG, KPMG의 2026년 4분기 시장 분석 보고서를 종합하고, 소프트웨어 정의 인프라(Software-Defined Infrastructure) 접근 방식을 통해 AI-Stack과 ixCSP가 기업의 GPU 자산을 측정 가능한 AI 성과로 전환하는 방법을 소개한다.
시장 인사이트 1. 수조 달러 규모의 컴퓨팅 인프라 투자, 하드웨어와 전력 설비에 집중되다
글로벌 AI 데이터센터의 자본적 지출(CAPEX)은 이미 수조 달러 규모에 진입했으며, 투자 자금은 지속적인 교체가 필요한 컴퓨팅 장비에 집중되고 있다. 이는 GPU 한 장의 활용 효율이 투자수익률(ROI)을 직접적으로 결정한다는 의미다.
|
출처 |
핵심 데이터 |
기업에 주는 시사점 |
|
2026~2050년 글로벌 데이터센터 자본적 지출의 중간 시나리오는 31조 6,000억 달러에 달한다. ICT 장비(서버, GPU, 네트워크 등)의 비중은 2026년 70%에서 2050년 93%로 증가한다. |
투자 자금의 중심은 건물이 아닌 주기적으로 교체되는 컴퓨팅 장비다. |
|
|
PwC(同上) |
GPU와 서버는 4~6년마다 교체되며, 20년의 자산 수명 동안 ICT 장비에 3~5차례 재투자가 필요하다. 건설비 1달러당 향후 약 12달러의 ICT 투자가 발생한다. |
GPU의 감가상각 주기가 짧기 때문에 유휴 시간이 길어질수록 자산 가치가 손실된다. |
|
McKinsey Technology Trends Outlook 2026 |
2030년까지 글로벌 데이터센터 자본적 지출은 약 7조 달러에 이를 수 있다. 미국 AI 인프라의 전력 수요는 2025년 약 30GW에서 2030년 90GW 이상으로 증가할 전망이다. |
전력은 구조적인 제약 요인이 되며, 단순한 증설보다 와트당 컴퓨팅 생산성이 중요해진다. |
|
Bain Technology Report 2026 |
2030년까지 5조~6조 5,000억 달러가 투자되고 약 150GW의 컴퓨팅 용량이 추가될 것으로 예상된다. 5대 하이퍼스케일 클라우드 사업자의 2026년 자본적 지출은 7,800억 달러에 달할 수 있으며, 이는 3년 전의 약 5배 수준이다. |
컴퓨팅 자원 부족은 저절로 해결되지 않으므로 기업은 기존 자산의 활용도를 극대화해야 한다. |
Bain은 전력, 하드웨어, 기술 인력이 동시에 제약을 받는 상황에서 시장의 자율적인 조정을 기다리는 기업은 경쟁에서 배제될 수 있다고 지적한다. 또한 기업의 기술 리더들이 컴퓨팅 자원의 확보를 공급망 위험인 동시에 전략적 자산으로 인식해야 한다고 권고한다.
대부분의 기업에서 가장 빠르고 통제 가능한 '새로운 컴퓨팅 자원'은 이미 보유한 GPU의 유휴 시간에 숨어 있다.
시장 인사이트 2. Agentic AI는 가치를 확대하는 동시에 컴퓨팅 및 토큰 비용도 증가시킨다
AI 컴퓨팅 자원의 주요 소비 영역이 학습에서 추론으로 이동하고 있다. McKinsey는 2030년 추론이 전체 데이터센터 수요의 30~40%를 차지하고, AI 컴퓨팅 수요의 과반을 차지할 것으로 전망한다. Agentic AI는 이러한 추세를 더욱 가속화한다.
AI의 가치는 이미 실현되고 있지만 선도 기업에 집중되고 있다. BCG Applied AI Index 2026은 1,300명 이상의 최고경영진(CxO)을 대상으로 조사한 결과, 약 50%의 기업이 AI를 통해 측정 가능한 가치를 창출했다고 밝혔다. 명확한 전략과 높은 활용 성숙도를 모두 갖춘 기업의 AI 창출 가치는 그렇지 않은 기업보다 5배 높았다(매출 대비 4.5% vs. 0.9%).
AI 지출은 빠르게 확대되고 있다. BCG 조사에서 기업의 AI 지출 비중은 전년도 매출의 약 1%에서 3.3%로 증가했다. McKinsey가 인용한 조사에서는 응답자의 93%가 AI 예산을 초과했다고 답했다.
토큰은 재무 관리의 핵심 항목이 되고 있다. McKinsey에 따르면 토큰 사용 비용과 추론 비용은 더 이상 무시할 수 있는 소액 비용이 아니라 중요한 운영비 항목이 되었다. 기업은 토큰 소비를 관리와 통제가 필요한 재무 자원으로 인식하기 시작했으며, 인프라 공급업체는 토큰 처리량, 토큰당 비용, 추론 효율성을 핵심 우선순위로 삼고 있다.
단가는 하락해도 총비용은 줄어들지 않는다. Bain은 토큰당 평균 비용은 감소하고 있지만 사용량이 더 빠르게 증가해 작업당 비용은 여전히 높다고 지적한다. 새로운 Agentic 워크플로의 초기 운영 비용은 최적화 이후보다 최대 10배 높을 수 있다.
선도 기업은 토큰 사용량을 적극적으로 관리한다. BCG에 따르면 미래 대응 역량을 갖춘 'future-built' 기업의 75%는 토큰 지출에 대해 명확한 투자수익 목표를 설정하고 있다. 반면 후발 기업의 50%는 토큰 사용량을 추적하지 않거나 제한을 설정하지 않는다.
플랫폼화가 경쟁력을 가르는 분기점이다. Future-built 기업의 3분의 2 이상은 단일 공급업체의 기술 스택에 의존하는 대신, 공통 아키텍처와 제어 평면(Control Plane)을 갖춘 전사 AI 플랫폼을 구축하고 있다. 반면 후발 기업에서는 그 비율이 약 5분의 1에 불과하다.
Bain은 비용을 '사용자 단위'가 아닌 '워크플로 단위'로 측정할 것을 권고한다. 실제로 중요한 질문은 제안서 한 건을 작성하거나 고객 문의 한 건을 해결하는 데 얼마의 비용이 드는가이다.
이것이 바로 AI FinOps의 출발점이다.
시장 인사이트 3. 제조업의 AI 확산이 본격화되면서 이기종 컴퓨팅 환경이 새로운 표준이 된다
기업의 AI 도입은 시범 운영(Pilot) 단계에서 대규모 확산 단계로 이동하고 있으며, 동시에 하드웨어 아키텍처도 다양해지고 있다. 이러한 변화가 맞물리면서 서로 다른 컴퓨팅 자원을 어떻게 통합적으로 스케줄링할 것인가가 IT 부서의 새로운 과제로 떠오르고 있다.
제조업의 AI 확산 일정. KPMG Global Tech Report 2026은 22개 국가 및 지역의 제조업 기술 리더 258명을 조사했다. 응답자의 49%는 AI 도입을 통해 이미 비즈니스 가치를 창출했다고 답했으며, 68%는 향후 12개월 이내에 AI를 대규모로 확산할 계획이라고 밝혔다. 또한 89%는 향후 5년 이내에 AI 에이전트 관리가 핵심 역량이 될 것으로 전망했다.
이기종 컴퓨팅은 예외가 아닌 표준이다. McKinsey는 데이터센터에 ASIC, 전용 가속기, 범용 프로세서가 각자의 역할을 수행하는 이기종 시스템이 확대되고 있다고 설명한다. Bain 역시 GPU, CPU, ASIC이 다양한 조합으로 추론 및 Agentic 워크로드를 지원하며, 맞춤형 반도체가 데이터센터 컴퓨팅 칩 중 가장 빠르게 성장하는 분야라고 분석한다.
Agentic 워크로드는 가속기의 유휴 시간을 증가시킬 수 있다. Bain에 따르면 AI 에이전트가 외부 도구 호출 결과를 기다리는 동안 가속기가 유휴 상태가 될 수 있으므로, 더욱 정교한 메모리 및 자원 스케줄링이 필요하다.
데이터와 거버넌스는 여전히 해결 과제다. KPMG 조사에서는 제조업 기술 리더의 76%가 신뢰할 수 없는 데이터를 AI의 주요 위험 요인으로 지목했다.
기업이 서로 다른 세대의 GPU와 NPU를 동시에 보유하고 여러 사업부의 학습 및 추론 수요를 지원해야 하는 상황에서, 통합 소프트웨어 계층이 없다면 컴퓨팅 자원은 개별적으로 고립된 사일로(Silo)가 될 수밖에 없다.
시장 인사이트 4. 평가 기준의 전환: 'GPU 보유량'에서 '토큰 생산량'으로
AI 인프라의 핵심 성과지표(KPI)는 자산 규모에서 단위 에너지 및 컴퓨팅 자원당 산출량으로 변화하고 있다.
Token Factory는 데이터센터를 토큰을 생산하는 공장으로 바라보는 개념이다. 전력과 컴퓨팅 자원을 투입해 토큰, 추론 결과, 완료된 AI 작업을 생산하는 것이다.
|
구분 |
기존 평가 방식 |
Token Factory 평가 방식 |
|
자산 |
GPU 수량, 랙 수, MW 용량 |
GPU 실제 활용률, 제공 가능한 컴퓨팅 자원 |
|
효율성 |
峰值效能(FLOPS) |
와트당 토큰 수, 달러당 토큰 수 |
|
서비스 제공 |
부서별 서버 제공 |
모델 학습 주기, 추론 지연시간, 작업 완료 건수 |
|
비용 |
프로젝트별 장비 구매 예산 |
토큰당 비용, 워크플로당 비용, 부서별 비용 배분 |
|
거버넌스 |
IT 자산 목록 |
멀티테넌트 할당량, 사용량 기반 과금, ROI 추적 |
McKinsey는 업계의 관점을 인용하며 추론이 기업 AI의 운영비용으로 자리 잡고 있다고 설명한다. 장기적인 AI 도입 확산은 모델 자체의 성능보다 경제적으로 지속 가능한 규모에서 추론 서비스를 제공할 수 있는지에 더욱 크게 좌우될 수 있다.
즉, 더 낮은 토큰당 비용으로 안정적인 서비스를 제공하는 기업이 AI 확장 경쟁에서 주도권을 확보하게 된다.
시장 인사이트 5. 학습, 추론, Agentic AI에는 서로 다른 자원 스케줄링이 필요하다
AI 워크로드마다 컴퓨팅 자원에 대한 요구사항은 크게 다르다. 모든 워크로드에 동일한 방식으로 GPU를 할당하면 자원 낭비가 발생할 수밖에 없다.
McKinsey는 추론 및 토큰 비용이 AI 확산을 저해하는 핵심 운영 과제가 되고 있다고 지적한다. Bain 역시 학습, 추론, Agentic 워크로드에 각각 적합한 하드웨어와 스케줄링 방식이 다르다고 설명한다.
|
워크로드 |
컴퓨팅 자원 요구 특성 |
일반적인 자원 낭비 |
|
모델 학습 |
높은 처리량, 대용량 HBM 메모리, 빠른 수평 확장 |
연속적인 멀티 GPU 자원을 확보하지 못해 작업이 대기 |
|
모델 추론 |
낮은 지연 시간. 디코딩 단계에서 토큰을 생성할 때마다 모델 가중치와 KV 캐시를 다시 읽어야 함 |
소규모 추론 서비스가 고성능 GPU 한 장을 독점 |
|
Agentic 워크플로 |
추론과 유사하지만 컨텍스트가 지속적으로 누적되며, KV 캐시 오프로딩 및 메모리 계층화가 필요 |
외부 도구 호출을 기다리는 동안 가속기가 유휴 상태로 전환 |
모델 자체의 변화도 스케줄링을 더욱 복잡하게 만든다.
단일 모델에서 모델 포트폴리오로 전환. McKinsey에 따르면 경쟁 우위는 가장 큰 모델을 확보하는 것에서 성능, 비용, 속도, 거버넌스의 균형을 고려한 모델 포트폴리오를 운영하는 것으로 이동하고 있다. 소형 언어 모델(SLM), 모델 압축, 오픈 웨이트(Open-Weight) 모델은 온프레미스 및 엣지 환경에서의 AI 배포를 더욱 현실적으로 만들고 있다.
작업을 수행할 수 있는 가장 작은 모델 활용. BCG는 요구사항을 충족할 수 있는 가장 작은 모델로 작업을 라우팅하고, 토큰당 비용 대신 성공적으로 완료된 결과당 비용을 평가 기준으로 사용할 것을 권고한다. Bain 역시 반복적인 작업에는 비용이 저렴하거나 자체 구축한 오픈 웨이트 모델을 활용할 것을 제안한다.
Physical AI가 학습 수요를 확대한다. McKinsey는 월드 모델(World Model)을 통해 기업이 시뮬레이션 환경에서 모델을 학습하고 검증할 수 있으며, GPU 가속 시뮬레이션을 통해 학습 기간을 크게 단축할 수 있다고 설명한다.
하나의 GPU 클러스터가 학습, 추론, Agentic 워크로드를 동시에 처리하면서 다양한 모델까지 지원해야 한다면, 기업에는 워크로드 특성에 따라 컴퓨팅 자원을 동적으로 분할·통합·스케줄링할 수 있는 소프트웨어 계층이 필요하다.
시장 인사이트 6. GPU를 구매했는데도 생산성이 높아지지 않는 이유: 5가지 핵심 병목 요인
많은 기업이 직면한 문제는 컴퓨팅 자원 자체의 부족이 아니라 보유 자원을 효율적으로 활용하지 못한다는 점이다. 다음 5가지 병목 요인은 GPU 자산이 실제 토큰 생산으로 전환되는 과정에서 발생하는 대표적인 비효율이다.
|
병목 요인 |
대표적인 현상 |
비즈니스 영향 |
|
GPU 유휴 자원 |
GPU 한 장을 특정 프로젝트나 사용자에게 독점 할당해 야간 및 주말에 유휴 상태 발생 |
4~6년의 감가상각 기간 동안 고가 자산의 가치가 지속적으로 손실 |
|
자원 단편화 |
소규모 추론 작업이 고성능 GPU 전체를 점유하는 반면, 대규모 학습에는 필요한 멀티 GPU 자원을 확보하지 못함 |
장부상 자원은 충분하지만 실제 사용 가능한 컴퓨팅 자원은 부족 |
|
워크로드 대기 |
수작업 또는 스프레드시트로 서버를 배정하고 우선순위 및 대기열 관리 체계가 없음 |
모델 개발 및 개선 주기가 길어지고 데이터 사이언티스트의 대기시간 증가 |
|
이기종 컴퓨팅 관리 |
서로 다른 제조사와 세대의 GPU/NPU를 개별적으로 관리하고 통합 인터페이스가 없음 |
운영 복잡성이 증가하고 신규 장비를 기존 자원 풀에 통합하기 어려움 |
|
이기종 컴퓨팅 관리 |
어떤 부서와 모델이 얼마의 비용을 사용하는지 파악하기 어려움 |
비용 배분과 ROI 산정이 어렵고 예산 초과가 지속됨 |
이 다섯 가지 병목의 공통적인 원인은 하드웨어는 'GPU 장수'를 기준으로 할당되지만, AI 워크로드는 '작업'을 기준으로 발생한다는 점이다.
해결책은 GPU를 추가 구매하는 것이 아니라, 하드웨어 위에 소프트웨어 계층을 구축해 컴퓨팅 자원을 분할하고 통합하며 스케줄링하고 사용량을 측정할 수 있도록 만드는 것이다.
INFINITIX AI-Stack × ixCSP: 소프트웨어로 하드웨어를 정의하고 완전한 Token Factory를 구현하다
AI-Stack과 ixCSP는 GPU 자원 풀부터 유료 서비스 사용자까지 연결하는 완전한 기술 스택을 구성한다.
AI-Stack이 '컴퓨팅 자원의 활용도를 극대화'한다면, ixCSP는 '컴퓨팅 자원을 서비스로 제공하고 수익화'하는 역할을 담당한다.
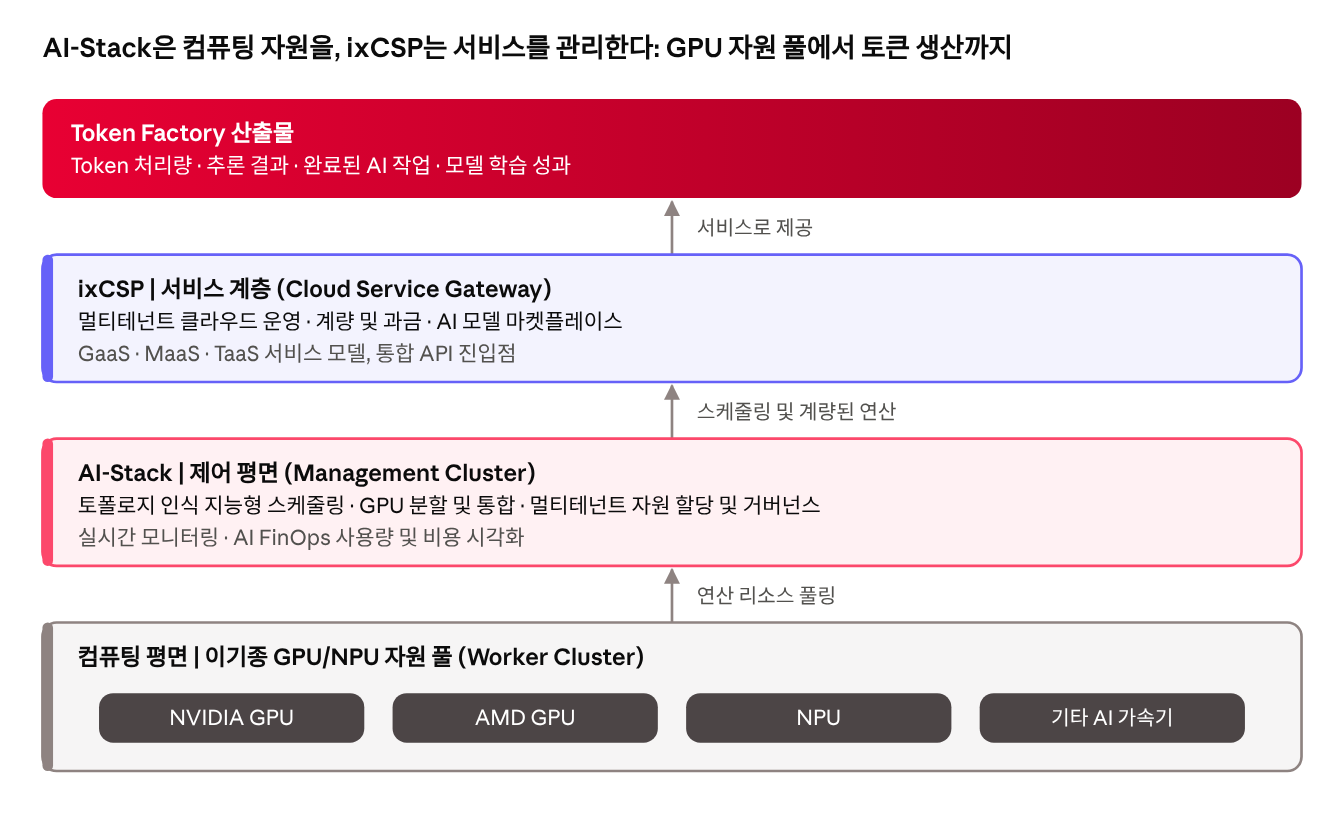
Token Factory 아키텍처: 컴퓨팅 평면, 제어 평면, 서비스 계층
하드웨어 계층은 지속적으로 교체하거나 서로 다른 제조사의 장비를 혼합해 사용할 수 있지만, 상위 계층의 스케줄링, 거버넌스, 과금 체계는 일관되게 유지된다.
이것이 바로 소프트웨어 정의 인프라의 핵심 가치다.
AI-Stack: GPU 자산을 스케줄링 가능한 컴퓨팅 자원 풀로 전환하다
AI-Stack은 INFINITIX의 GPU 자원 관리 플랫폼으로, '소프트웨어 정의 GPU 및 AI 인프라'를 지향한다.
Token Factory의 컴퓨팅 평면(Compute Plane)과 제어 평면(Control Plane)을 담당하며, 분산된 이기종 GPU/NPU를 하나의 자원 풀로 통합하고 워크로드 요구사항에 따라 동적으로 할당한다.
|
AI-Stack 주요 기능 |
해결하는 병목 |
기업이 얻는 효과 |
|
GPU 분할 및 통합 |
GPU 유휴 자원, 자원 단편화 |
소규모 작업은 하나의 GPU를 공유하고, 대규모 작업은 여러 GPU와 노드의 컴퓨팅 자원을 통합 |
|
토폴로지 인식 지능형 스케줄링(Topology-Aware Scheduling) |
워크로드 대기 |
우선순위와 하드웨어 토폴로지를 고려한 자동 자원 할당으로 대기 및 학습시간 단축 |
|
이기종 컴퓨팅 자원 통합 |
이기종 컴퓨팅 관리 |
서로 다른 제조사 및 세대의 GPU/NPU를 통합 인터페이스로 관리 |
|
멀티테넌트 거버넌스 |
자원 경합, 권한 관리 혼선 |
부서 및 프로젝트별 자원 할당량, 격리 정책, 접근 권한 설정 |
|
실시간 모니터링 및 AI FinOps 시각화 |
불투명한 비용 |
부서, 프로젝트, 모델별 사용량과 비용을 추적해 비용 배분 및 ROI 분석 지원 |
INFINITIX의 고객 도입 사례에 따르면 AI-Stack은 GPU 활용률을 90% 이상으로 높이고, 개발 환경 구축 시간을 2주에서 1분으로 단축해 산업 현장의 AI 도입과 운영을 가속화할 수 있다.
2026년 AI-Stack은 의료, 제조, Physical AI 연구 분야에서 적용 범위를 지속적으로 확대하고 있다.
가오슝의과대학교 부속 중허기념병원(高雄醫學大學附設中和紀念醫院, KMUH)
대만 최초로 NVIDIA B300 GPU 플랫폼을 도입한 의료기관으로, AI-Stack을 핵심 AI 인프라 관리 계층으로 활용한다. 중앙집중식 GPU 스케줄링, 워크로드 거버넌스, 자원 시각화를 제공해 대규모 언어 모델(LLM)과 비전 언어 모델(VLM)이 임상 및 연구 환경에서 안정적으로 운영될 수 있도록 지원한다.
AI-Stack을 도입해 NVIDIA B200 GPU 컴퓨팅 자원을 통합했다. 지능형 스케줄링과 자원 분할을 통해 컴퓨팅 자원을 유연하게 배분하며, 멀티테넌트 관리 및 접근 권한 제어를 통해 여러 의료진과 연구 프로젝트가 동시에 AI 모델을 개발·학습·검증할 수 있도록 지원한다.
일본 국립대학법인 전기통신대학교(University of Electro-Communications) ELSA 연구실
Physical AI 연구개발을 가속화하기 위해 AI-Stack을 도입했다. GPU 자원 풀링과 지능형 스케줄링을 통해 연구팀이 필요에 따라 즉시 컴퓨팅 자원을 확보하고, Physical AI 모델의 개발·학습·검증을 수행할 수 있도록 지원한다.
한국 스마트제조혁신센터(Smart Manufacturing Innovation Center, SMIC)
한국전자기술연구원(KETI)이 구축한 국가급 실증 환경이다. AI-Stack은 제조 AI를 위한 공유 컴퓨팅 플랫폼 구축을 지원하며, 멀티테넌트 아키텍처를 기반으로 여러 연구자와 프로젝트가 동시에 AI 모델을 개발·학습·검증할 수 있도록 한다.
또한 지능형 스케줄링을 통해 GPU 유휴 자원을 줄이고 제조업 특화 파운데이션 모델(Manufacturing Foundation Model, MFM) 연구를 지원한다.
BCG가 제시한 '단일 공급업체의 기술 스택이 아닌 공통 아키텍처와 제어 평면'이라는 기준에서 볼 때, AI-Stack은 기업 컴퓨팅 자원 계층의 제어 평면 역할을 수행한다.
하드웨어는 다양해질 수 있지만, 관리 체계는 통합되어야 한다.
ixCSP: 컴퓨팅 자원을 측정 가능한 AI 서비스로 전환하다
ixCSP는 INFINITIX의 AI 클라우드 운영 플랫폼으로, 'AI 인프라를 Token Factory로 전환하는 플랫폼'을 지향한다.
AI-Stack이 컴퓨팅 자원의 활용도를 극대화한다면, ixCSP는 이를 서비스 형태로 제공하고 사용량을 측정하며 과금할 수 있도록 한다.
즉, ixCSP는 Token Factory의 서비스 계층(Service Layer)을 담당한다.
|
ixCSP 주요 기능 |
해결하는 문제 |
기업이 얻는 효과 |
|
멀티테넌트 클라우드 운영 |
내부 컴퓨팅 자원에 대한 셀프서비스 접근의 어려움 |
부서, 자회사, 외부 고객이 셀프서비스 방식으로 컴퓨팅 자원과 모델 활용 |
|
사용량 측정 및 과금(Metering & Billing) |
비용 귀속의 어려움 |
GPU 사용 시간, API 호출, 토큰 사용량에 따른 정밀 과금 및 비용 배분 |
|
AI 모델 마켓플레이스 |
모델 배포 및 접근의 높은 진입장벽 |
모델을 중앙에서 등록하고 사용자가 원클릭으로 활용 |
|
GaaS · MaaS · TaaS 서비스 모델 |
컴퓨팅 자원을 서버 단위로만 제공 |
GPU, 모델, 토큰의 세 가지 단위로 서비스 제공 |
|
클라우드 서비스 게이트웨이(Cloud Service Gateway) |
외부 서비스 제공을 위한 통합 진입점 부족 |
API 접근, 사용량 측정, 과금 기능 통합 |
ixCSP는 크게 두 가지 환경에 적합하다.
첫째는 기업 내부의 프라이빗 AI 클라우드다. IT 부서가 컴퓨팅 자원과 모델을 서비스로 제공하고, 사용량에 따라 각 사업부에 비용을 배분함으로써 Bain이 제시한 '워크플로 단위 비용 관리' 원칙을 실현할 수 있다.
둘째는 GPU 클라우드 서비스 사업자, 통신사, 소버린 AI 컴퓨팅 센터다. 자체 인프라를 기반으로 유료 AI 서비스를 출시해 자본적 지출을 반복적인 매출(Recurring Revenue)로 전환할 수 있다.
권장 도입 단계
-
자산 현황 파악 및 기준선 수립
기존 GPU/NPU 자산을 조사하고 GPU 활용률, 작업 대기 시간, 부서별 사용량에 대한 기준선을 수립한다.
-
자원 풀링(Resource Pooling)
AI-Stack으로 이기종 컴퓨팅 자원을 통합하고 GPU 분할·통합 및 지능형 스케줄링을 적용한다. 유휴 자원과 단편화된 컴퓨팅 자원을 우선적으로 회수해 활용도를 높인다.
-
학습과 추론 워크로드의 분리 및 스케줄링
워크로드 특성에 따라 컴퓨팅 자원을 배분한다.
모델 학습에는 GPU 통합 및 멀티노드 연산을 활용해 연속적인 멀티 GPU 자원을 확보하고, 우선순위 기반 스케줄링으로 학습 주기를 단축한다.
모델 추론에는 GPU 분할 기능을 활용해 여러 추론 서비스가 컴퓨팅 자원을 공유하도록 한다. 모델 크기와 지연시간 요구사항에 따라 자원을 배분해 소규모 서비스가 고성능 GPU 전체를 독점하지 않도록 한다.
또한 비혼잡 시간대의 추론용 컴퓨팅 자원을 회수해 학습 작업에 재할당할 수 있다.
-
거버넌스 및 가시성 확보
멀티테넌트 자원 할당량을 설정하고 AI FinOps 대시보드를 도입해 부서, 프로젝트, 모델별로 비용을 추적하고 배분할 수 있도록 한다.
-
서비스화
ixCSP를 통해 GPU, 모델, 토큰 기반 서비스를 제공한다. 내부적으로는 사용량에 따른 비용 배분을, 외부적으로는 서비스 과금을 구현한다.
-
토큰 중심 KPI 관리
와트당 토큰 생산량, 토큰당 비용, 워크플로당 비용을 지속적으로 추적하고, 이를 다음 하드웨어 투자 의사결정의 기준으로 활용한다.
결론: 다음 경쟁의 핵심은 GPU 한 장당 토큰 생산 역량이다
. 컴퓨팅 자원의 공급이 전력과 공급망의 제약을 받고, Agentic AI의 확산으로 토큰 수요가 급증하는 상황에서 기업이 가장 큰 투자 효과를 얻을 수 있는 방법은 반드시 GPU를 추가 구매하는 것이 아니다.
기존 GPU를 최대한 활용하고, 적절한 워크로드에 배분하며, 비용과 성과를 명확하게 측정하는 것이 더 중요할 수 있다.
하드웨어는 시간이 지나면 교체되지만, 소프트웨어로 정의된 관리 역량은 지속적으로 축적된다.
더 중요한 변화는 AI 워크로드가 학습 중심에서 학습, 추론, Agentic AI가 공존하는 구조로 전환되고 있다는 점이다.
기업의 모델 전략 역시 단일 대형 모델에 의존하는 방식에서 다양한 크기의 모델과 오픈 웨이트 모델을 조합해 운영하는 방향으로 발전하고 있다.
이에 따라 평가 기준도 토큰당 비용에서 성공적으로 완료된 작업당 비용으로 변화하고 있다.
워크로드 특성에 따라 컴퓨팅 자원을 동적으로 분할·통합·스케줄링하고, 모든 컴퓨팅 자원을 측정 가능한 성과와 연결하는 역량이 Token Factory의 확장성을 결정하는 핵심 요소가 될 것이다.
INFINITIX(인피니틱스)는 2003년 대만 타이베이에서 설립된 이후 250개 이상의 기업과 기관에 서비스를 제공해 왔으며, 대만, 일본, 한국 및 동남아시아 시장으로 사업을 확대하고 있다.
AI-Stack과 ixCSP 제품 데모 및 GPU 활용률 분석, Token Factory 도입 방안에 대한 상담이 필요하시다면 INFINITIX 팀에 문의해 주시기 바랍니다.
참고 자료
-
McKinsey & Company, Technology Trends Outlook 2026(보고서 PDF)
-
Bain & Company, Technology Report 2026(보고서 PDF);含「New Innovation Is Required to Fund AI's $6 Trillion Buildout」、「AI Data Center Boom」、「Managing Token Spending without Choking Off Opportunity」등의 장 포함
-
BCG, The Formula for Agentic AI Value: The Applied AI Index 2026, 2026/09(보고서 PDF)
-
KPMG, Global Tech Report 2026: Interoperability, AI, and the new rules of manufacturing excellence
-
INFINITIX 제품 및 고객 도입 자료:www.infinitix.ai

